
Orphaned Content, hay trang mồ côi, là URL không nhận được liên kết nội bộ có thể crawl từ những trang khác trên website. URL vẫn có thể xuất hiện trong sitemap, Search Console, backlink hoặc lịch sử truy cập, nhưng người dùng và crawler khó tìm thấy nó bằng hành trình điều hướng thông thường.
Trang mồ côi không tự động là trang xấu. Một landing page chiến dịch, trang cảm ơn hoặc tài liệu chỉ dành cho một nhóm người dùng có thể cố ý không nằm trong navigation. Vấn đề xuất hiện khi một URL đáng lẽ phải được khám phá, index hoặc tạo chuyển đổi lại không có đường dẫn nội bộ phù hợp.
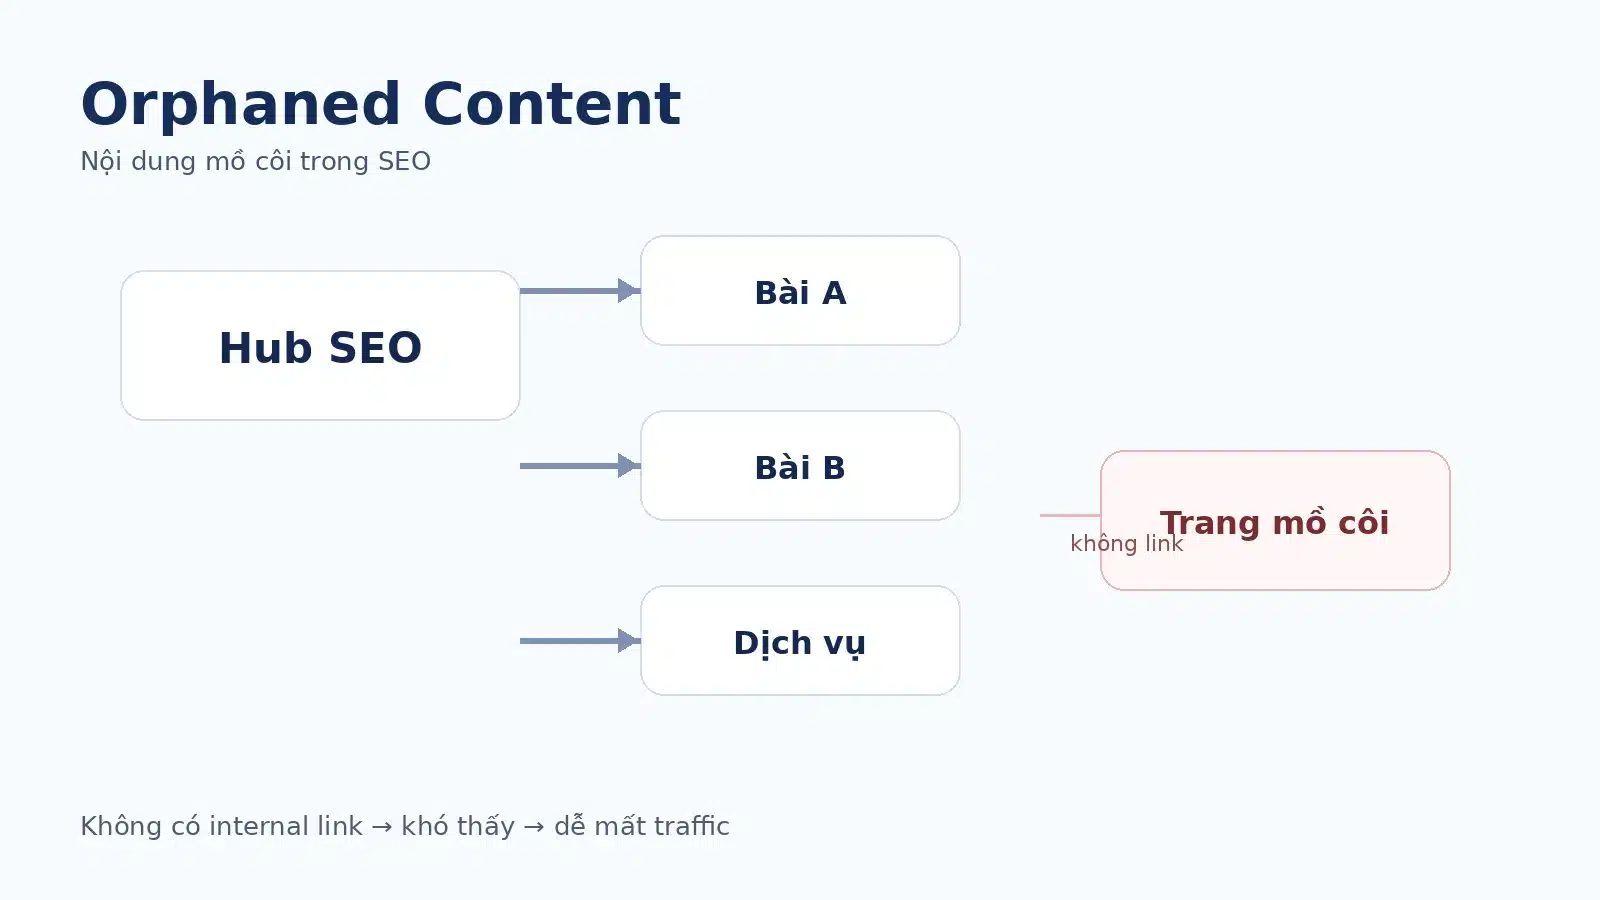
Trang mồ côi khác trang ít liên kết thế nào?
| Trạng thái | Đặc điểm | Cách xử lý |
|---|---|---|
| Orphaned Content | Không có inbound internal link có thể crawl | Xác định mục đích rồi thêm đường dẫn, hợp nhất hoặc loại bỏ |
| Weakly linked page | Có link nhưng rất ít hoặc từ nguồn không phù hợp | Đánh giá lại source–target map và navigation |
| Unlinked from menu | Không ở menu nhưng vẫn có contextual link | Có thể hoàn toàn bình thường |
| Noindex utility page | Trang phục vụ tác vụ nhưng không cần xuất hiện trên Search | Giữ nếu hữu ích; không cần ép vào cấu trúc SEO |
| Dead URL | Không còn nội dung hoặc mục đích | 404/410 hoặc redirect đến trang tương đương khi phù hợp |
Vì sao trang mồ côi xuất hiện?
- Bài mới được publish nhưng chưa thêm vào hub, category hoặc bài liên quan.
- Menu, block liên quan hoặc template bị thay đổi.
- URL cũ còn trong sitemap sau khi website tái cấu trúc.
- Landing page chiến dịch được tạo ngoài quy trình nội dung.
- Pagination, filter hoặc tìm kiếm nội bộ tạo URL không được quản trị.
- Nội dung được import từ website cũ nhưng không được gắn lại vào kiến trúc mới.
- Link được tạo bằng nút hoặc JavaScript không xuất thành thẻ
<a href>có thể crawl.
Vì vậy, tìm trang mồ côi không thể chỉ dựa vào một crawler. Crawler bắt đầu từ một URL sẽ không tự nhìn thấy trang không có đường dẫn đến nó; cần đối chiếu nhiều nguồn inventory.
Nguồn dữ liệu cần đối chiếu
| Nguồn | Giúp phát hiện | Giới hạn |
|---|---|---|
| Crawl website | URL tìm thấy qua link nội bộ | Không thấy URL thật sự mồ côi |
| XML sitemap | URL mà website khai báo ưu tiên | Sitemap có thể cũ hoặc chứa URL không nên index |
| Search Console | URL Google đã biết, crawl hoặc index | Không phải inventory đầy đủ theo thời gian thực |
| Analytics/CRM | Landing page có phiên truy cập hoặc conversion | Phụ thuộc tracking và consent |
| CMS/database | Toàn bộ nội dung đang lưu | Có thể gồm draft, private hoặc revision |
| Backlink data/log | URL được truy cập từ bên ngoài | Không chứng minh vai trò nội bộ |
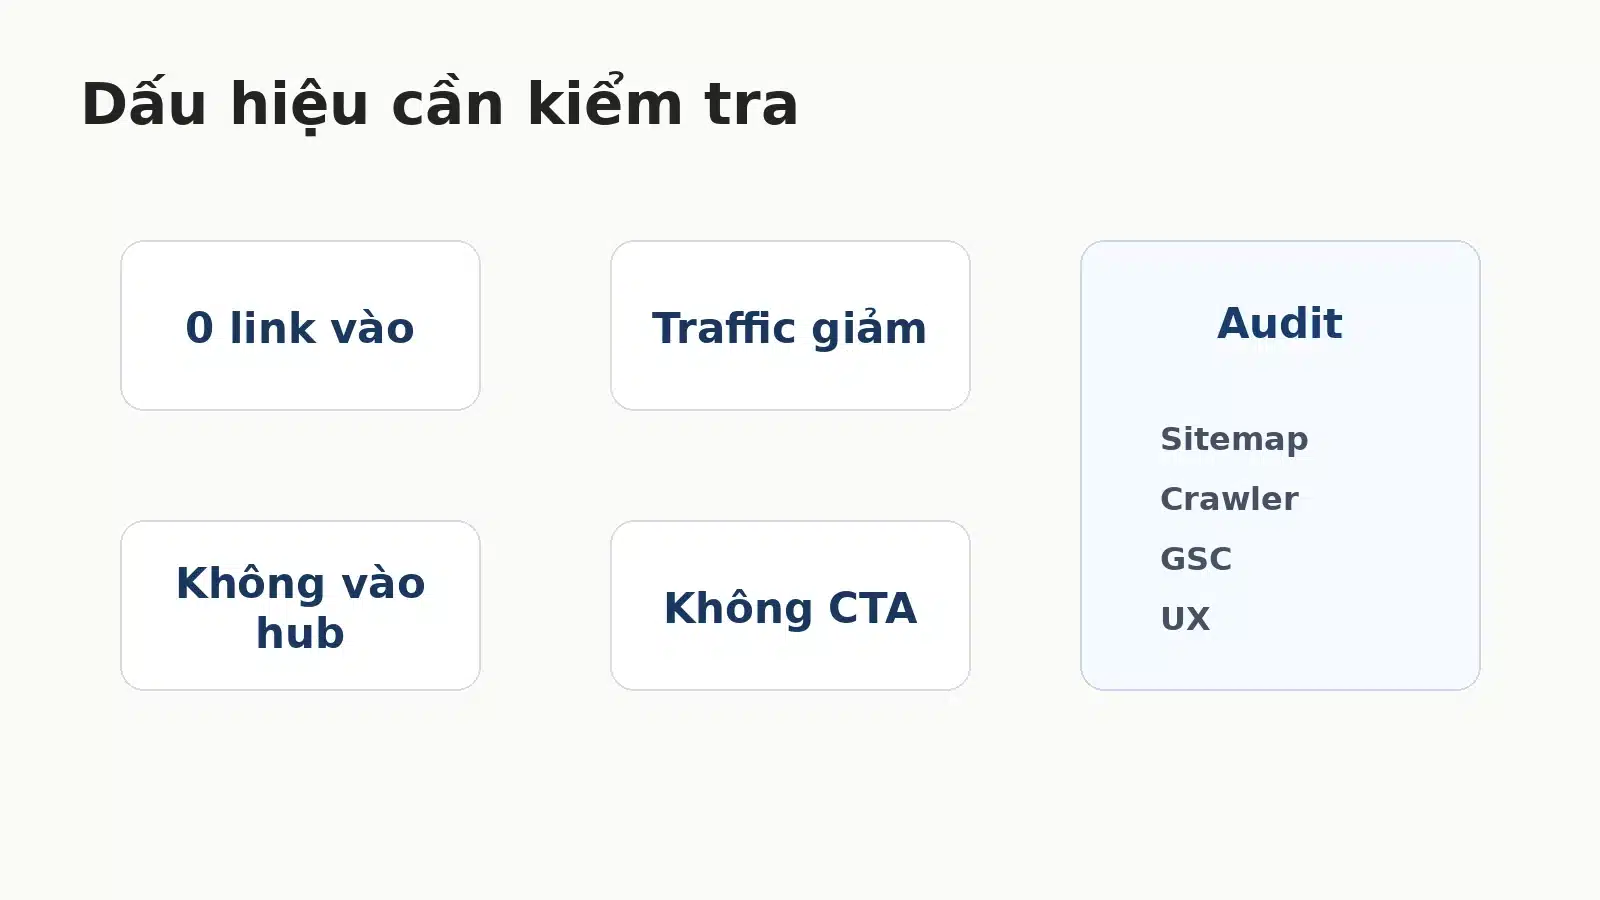
Một quy trình thực tế là lấy URL từ CMS, sitemap, Search Console, analytics và backlink data, chuẩn hóa chúng rồi so sánh với danh sách URL crawler tìm thấy. Những URL tồn tại ở nguồn khác nhưng không có trong crawl graph là ứng viên cần kiểm tra.
Phân loại trước khi sửa
- Intended-indexable: trang dịch vụ, sản phẩm, category hoặc nội dung hỗ trợ cần được tìm thấy.
- Utility: trang cảm ơn, đăng nhập, tài khoản hoặc kết quả thao tác.
- Campaign: landing page có thời hạn, nguồn traffic riêng và tracking riêng.
- Duplicate/near-duplicate: URL trùng hoặc gần trùng một owner URL khác.
- Expired: nội dung không còn đúng, không còn nhu cầu hoặc không còn sản phẩm.
Không nên thêm internal link cho mọi URL chỉ để làm sạch báo cáo. Một trang không còn giá trị cần được hợp nhất, redirect hoặc trả trạng thái phù hợp; đưa nó vào navigation chỉ làm cấu trúc rối hơn.
Ma trận xử lý Orphaned Content
| Tình huống | Hành động | Xác minh |
|---|---|---|
| Trang hữu ích, đúng intent | Thêm contextual link, hub, category hoặc navigation phù hợp | Crawler tìm thấy link và URL vẫn indexable |
| Trang trùng owner URL khác | Hợp nhất; redirect nếu URL phụ không còn cần | Redirect đúng đích, internal link và sitemap đã cập nhật |
| Trang cần giữ nhưng không cần Search | Giữ đường dẫn phục vụ người dùng; cân nhắc noindex theo mục đích | Không chặn crawl trước khi Google xử lý noindex |
| Trang chiến dịch còn hoạt động | Giữ nguồn traffic, tracking và fallback navigation cần thiết | Form, CTA và attribution hoạt động |
| Trang hết hạn, không có thay thế | 404 hoặc 410 | Không còn sitemap/internal link trỏ đến URL |
Cách thêm liên kết đúng ngữ cảnh
- Chọn source page có audience và nhiệm vụ liên quan.
- Dùng anchor mô tả điều người đọc sẽ thấy ở trang đích.
- Tạo link HTML thật với thuộc tính
href. - Không chèn cùng một link vào mọi bài hoặc footer chỉ để tăng số lượng.
- Ưu tiên owner URL canonical, không link tới biến thể tham số hoặc URL redirect.
- Giữ trải nghiệm mobile và nội dung link tương đương về ý nghĩa.
Xem thêm cách xây Internal Linking theo source–target map và cách tổ chức Content Hub.
Kiểm tra indexability riêng biệt
Không có internal link chỉ là vấn đề discovery và kiến trúc. Để một trang intended-indexable có thể xuất hiện trong Search, còn phải kiểm tra HTTP status, robots, noindex, canonical, nội dung render, sitemap và chất lượng trang.
- URL trả 200 và không bị redirect ngoài dự kiến.
- Robots.txt không chặn tài nguyên hoặc URL cần crawl.
- Không có noindex ngoài ý muốn.
- Declared canonical trỏ đến URL phù hợp.
- Nội dung chính và link xuất hiện sau render.
- Sitemap chỉ chứa phiên bản canonical, indexable và trả 200.
Đọc Technical SEO để tách discovery, crawl, render, indexability và canonical selection.
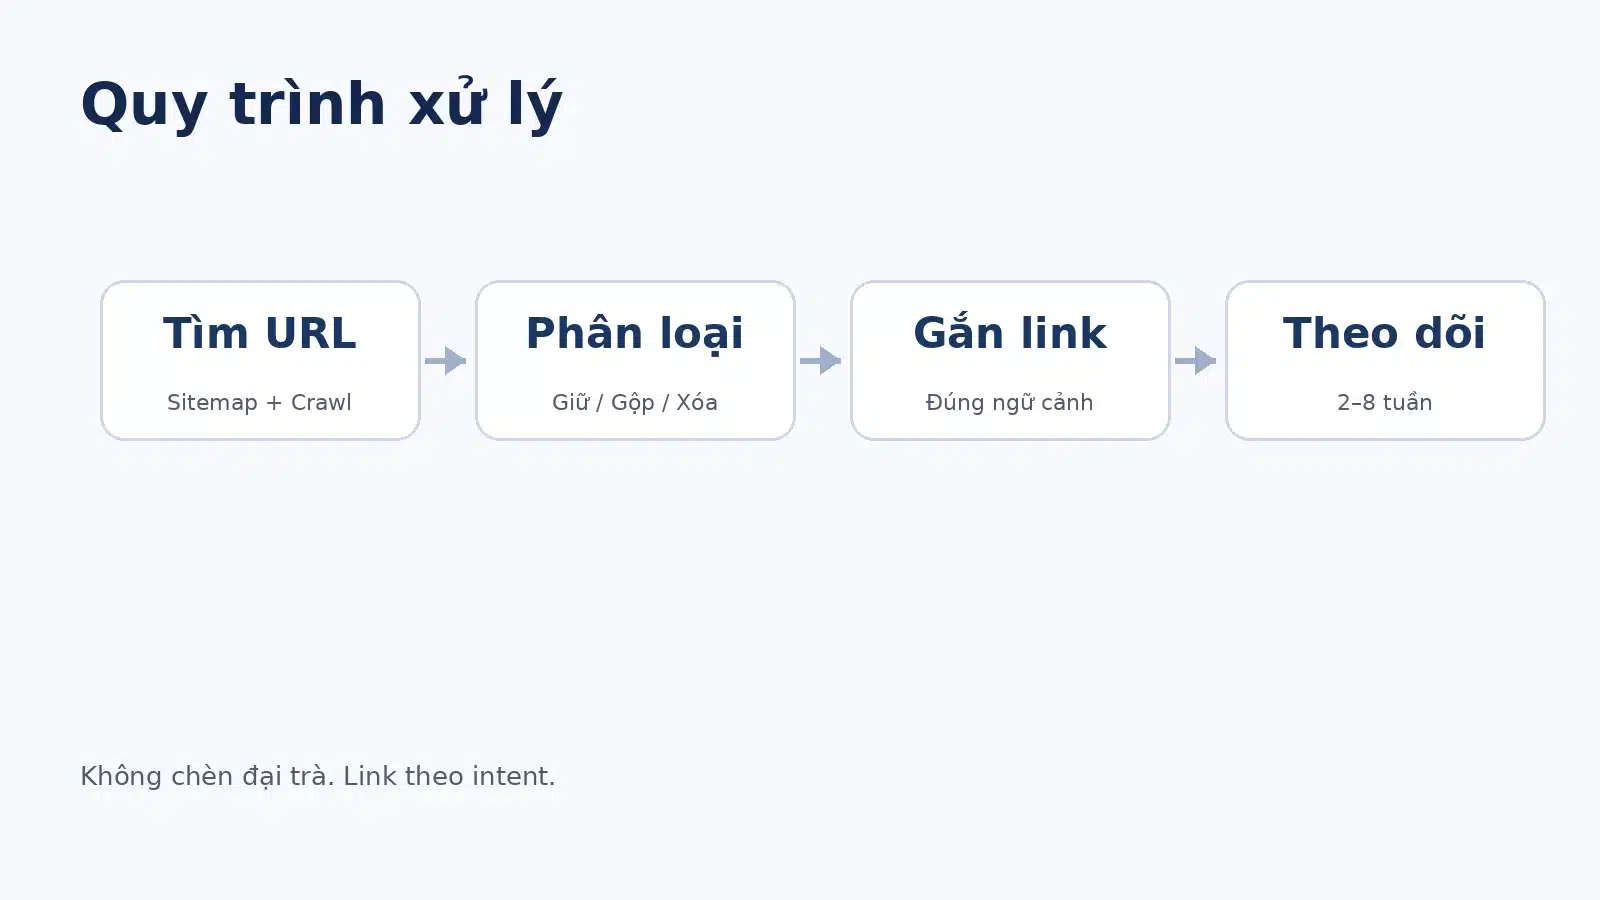
Quy trình audit và xác minh
- Khóa domain, page type và nhóm URL intended-indexable.
- Thu inventory từ CMS, sitemap, Search Console, analytics và backlink data.
- Crawl website từ trang chủ và các entry point quan trọng.
- So sánh inventory với crawl graph.
- Phân loại giữ, liên kết, hợp nhất, redirect, noindex hoặc loại bỏ.
- Snapshot trước khi thay đổi; pilot theo một page type khi phạm vi lớn.
- Read-back HTML, internal link, canonical, sitemap và status code.
- Theo dõi query, landing page và qualified outcome khi có dữ liệu mới.
Các lỗi thường gặp
- Coi mọi URL không có traffic là trang mồ côi.
- Dùng sitemap như bằng chứng duy nhất rằng cấu trúc internal link đã tốt.
- Thêm link sitewide không liên quan chỉ để vượt ngưỡng công cụ.
- Redirect hàng loạt về trang chủ.
- Noindex hoặc xóa URL trước khi kiểm tra backlink, conversion và mục đích.
- Chỉ kiểm tra source HTML mà không kiểm tra rendered link.
- Cam kết thời gian index hoặc tăng traffic sau khi thêm link.
Kết luận
Orphaned Content là vấn đề về đường dẫn khám phá, nhưng cách xử lý phải dựa trên page purpose. Trang hữu ích cần được nối vào kiến trúc; trang trùng cần hợp nhất; trang tiện ích hoặc hết hạn cần quy tắc khác.
Hãy dùng inventory nhiều nguồn, crawl graph và acceptance criteria thay vì một điểm số công cụ. Sau khi sửa, xác minh cả link HTML, indexability, canonical, sitemap và hành trình người dùng.
Nhận tư vấn website và SEO theo mục tiêu kinh doanh
Chúng tôi giúp bạn xác định vấn đề ưu tiên, hướng triển khai và cách đo lường hiệu quả.
Nhận tư vấn miễn phí →
Đoàn Trình Dục
Đoàn Trình Dục là tác giả và biên tập viên nội dung SEO tại TSNZone – Chi nhánh TD Digital Phú Yên. Anh tham gia xây dựng hệ thống nội dung trên kythuatseo.net với trọng tâm là SEO Onpage, Technical SEO, Internal Link, Content Hub, Entity SEO và tối ưu website WordPress cho doanh nghiệp. Trong quá trình biên tập, Đoàn Trình Dục ưu tiên cấu trúc nội dung rõ ràng, đúng mục tiêu tìm kiếm, có khả năng áp dụng thực tế và hạn chế diễn giải mơ hồ. Mỗi bài viết được rà soát theo các tiêu chí như tiêu đề, heading, liên kết nội bộ, tính dễ hiểu, tính nhất quán và khả năng kiểm chứng trước khi xuất bản. Mục tiêu nội dung là giúp chủ doanh nghiệp, người quản trị website và đội ngũ marketing hiểu đúng về SEO, tránh triển khai theo cảm tính và từng bước xây dựng website có khả năng tạo ra khách hàng từ Google.
Xem hồ sơ tác giả →

